论文解读

Self-Distillation Enables Continual Learning
自蒸馏使持续学习成为可能

SDFT 以“看过示范的自己”作为教师,把专家示范转化为 on-policy 训练信号。与 SFT 相比,它学会新任务的同时遗忘少得多。

Idan Shenfeld、Mehul Damani、Jonas Hübotter、Pulkit Agrawal · MIT、Improbable AI Lab、ETH Zurich
arXiv 2601.19897v2(2026-08-07)· 代码:github.com/Continual-Intelligence/Self-Distillation

65.4 vs 56.0
Tool Use 训练后旧任务平均分,SDFT vs SFT(基座 65.5)
70.6 vs 63.2
Tool Use 准确率,SDFT vs SFT(基座 42.9)
98 vs 80
新注入的 2025 年事实上的 OOD 准确率,SDFT vs SFT

动机:on-policy 学习遗忘更少,但需要奖励函数

只有示范数据时,默认做法是 SFT,而 SFT 是 off-policy 的。

核心矛盾

  • 持续学习:获得新技能和新知识,同时不损害已有能力。目前部署后的模型参数是静态的。
  • on-policy 训练(在模型自己的采样上学习)比 off-policy 训练遗忘少得多(RL's Razor,Shenfeld 等 2025;Chen 等 2025),泛化也更好(Chu 等 2025)。
  • 成功的 on-policy 方法大多是强化学习,需要显式奖励,而很多实际场景没有奖励。
  • 从示范学习以 SFT 为主:在固定的专家分布上训练,测试时误差累积(Ross 等 2011),并造成灾难性遗忘。

问题:只有示范时,如何做 on-policy 学习?

已有路线及其不足

  • Inverse RL(IRL):先推断奖励,再做 on-policy RL。需要很强的结构先验(最大熵、对抗判别器、偏好对),否则问题病态或代价过高。
  • Context distillation(Bai 等 2022;Snell 等 2022):带额外上下文的模型教不带上下文的自己。通常是offline 的、在教师采样上训练,且上下文是固定的(如行为准则、少样本示例)。

SDFT 的不同之处

  • 蒸馏是 on-policy 的:学生在自己生成的轨迹上训练,教师在学生真正犯错的地方纠正。
  • 教师的上下文是每个问题对应的那条示范,而非全局前缀,因此能表达细粒度的任务意图。
  • 用预训练模型的 in-context learning(ICL)能力代替显式奖励模型。
  • 同期独立工作提出了类似的自蒸馏:Zhao 等 2026;Hübotter 等 2026(“RL via self-distillation”)。

方法概览:同一个模型以两种模式运行,教师比 SFT 更靠近基座

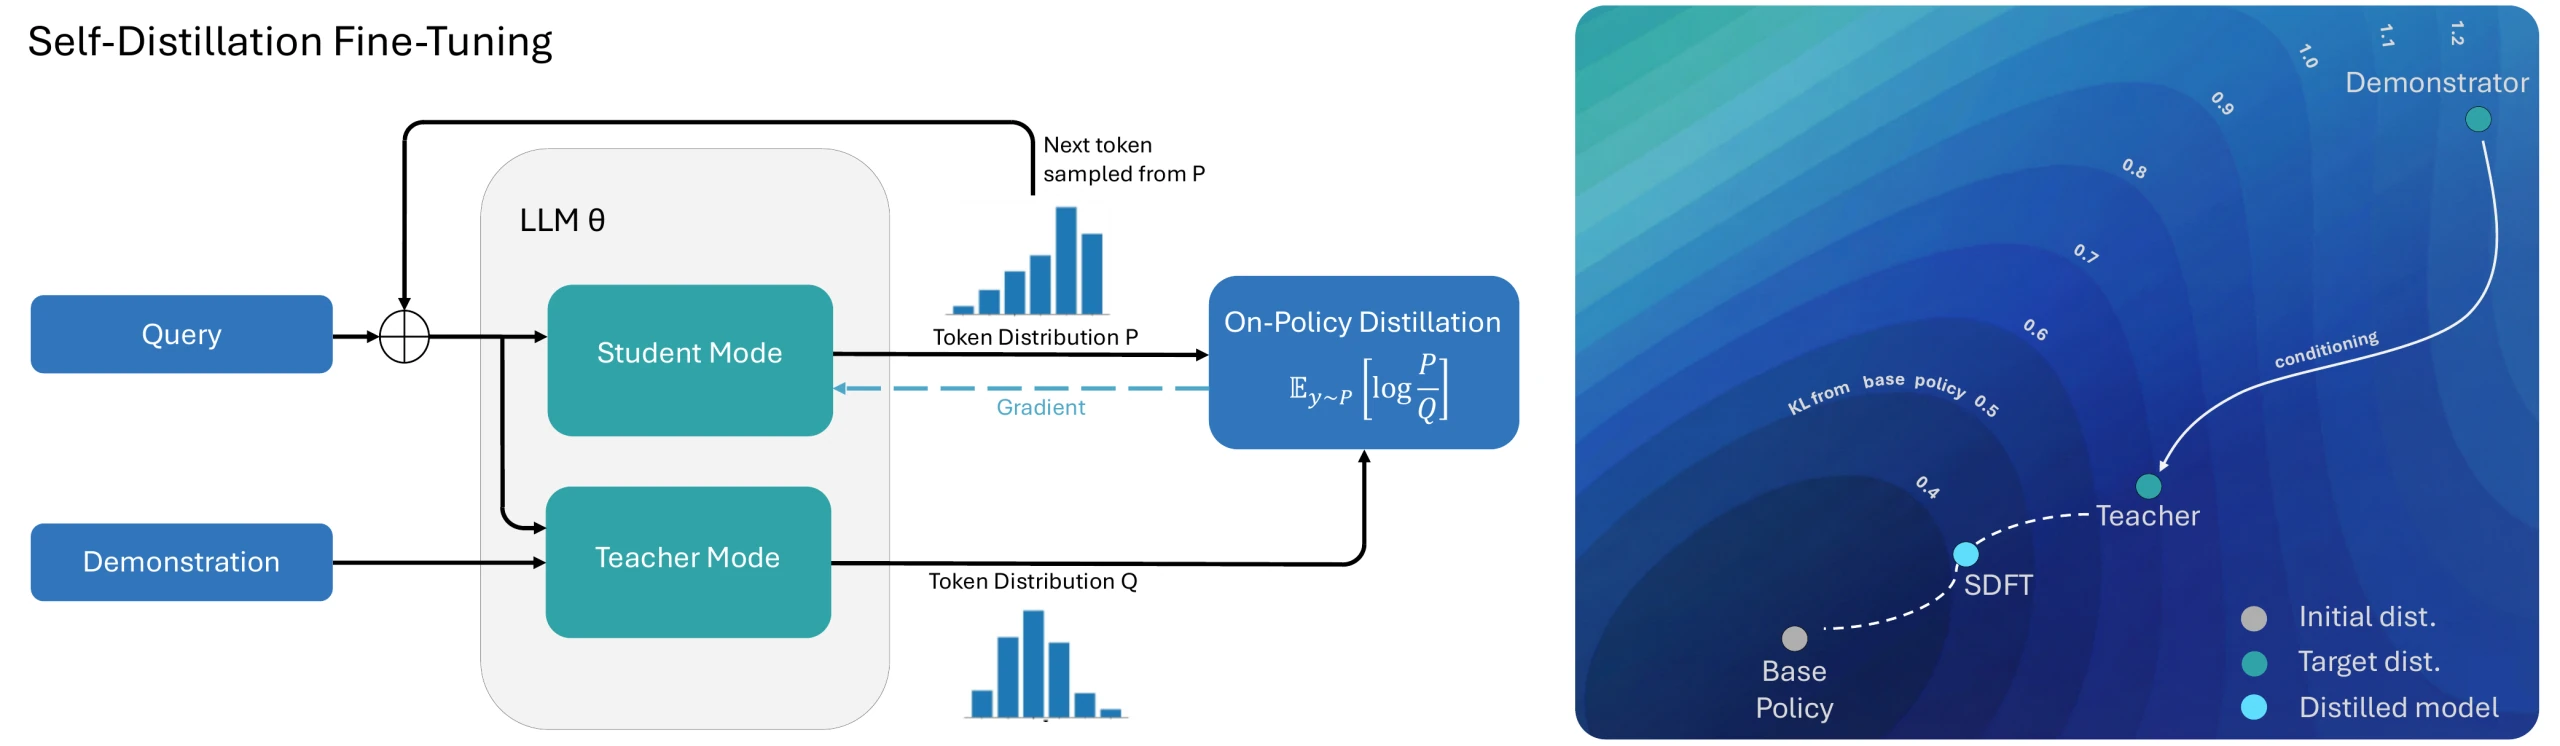
左:SDFT 的训练流程;右:示范条件教师的输出分布离基座更近,同时保持相同的新任务准确率。

论文图 2:SDFT 流程与分布示意
论文图 2。左半部分:query 进入 student mode 采样 token,同一个 LLM 在 teacher mode 下额外看到 demonstration,二者的 token 分布 $P$ 与 $Q$ 之间的 KL 给出梯度。右半部分:从 base policy 出发,SDFT 的终点比 SFT 更靠近基座,同时到达 demonstrator 附近的目标区域。

Student mode

只看问题 $x$,生成回答 $y\sim\pi_\theta(\cdot\mid x)$。训练数据全部来自这里,所以是 on-policy。

Teacher mode

同一模型(EMA 权重)额外看到示范 $c$,在学生生成的每个位置给出分布 $\pi(\cdot\mid y_{\lt t},x,c)$。

关键量化(§3.2)

到基座的 KL:教师 0.68 nats,SFT 模型 1.26 nats;新任务准确率相同。

方法:一个模型,两个角色

教师是同一个模型、额外看到示范;学生只看到问题,并负责生成训练轨迹。

角色

学生$P=\pi_\theta(\cdot\mid x)$
只看问题
采样回答 $y$
在 $y$ 上
匹配教师
←
教师$Q=\pi(\cdot\mid x,c)$
同一模型 + 示范 $c$
给学生的 token 打分

教师 prompt(原文)

<Question>
This is an example for a response to the question:
<Demonstration>
Now answer with a response of your own, including the thinking process:

作者发现这个 prompt 足以避免教师照抄 $c$;教师会给出自己的回答,体现它对示范意图的理解。

符号

  • $\theta$:学生参数,梯度只流向它。第 $k$ 步的取值记为 $\theta_k$,并简写 $\pi_k\equiv\pi_{\theta_k}$(下两页使用)。
  • 教师 $\pi(\cdot\mid x,c)$ 在损失中视为常数。推导中它与学生共享参数 $\theta_k$;实现中它是 EMA 参数 $\phi$,即 $\pi_\phi(\cdot\mid x,c)$(下一页算法)。

目标函数

从学生采样 $y$,最小化学生到教师的 KL:

$$\mathcal{L}(\theta)=D_{\mathrm{KL}}\big(\pi_\theta(\cdot\mid x)\,\|\,\pi(\cdot\mid x,c)\big)=\mathbb{E}_{y\sim\pi_\theta(\cdot\mid x)}\left[\log\frac{\pi_\theta(y\mid x)}{\pi(y\mid x,c)}\right]$$(1)

第一步,对 (1) 求梯度。$\theta$ 同时出现在采样分布和 log 比值里;对前者用 score-function 恒等式 $\nabla\pi_\theta=\pi_\theta\nabla\log\pi_\theta$,后者贡献 $\mathbb{E}_{y\sim\pi_\theta}[\nabla_\theta\log\pi_\theta(y\mid x)]=0$:

$$\nabla_\theta\mathcal{L}=\mathbb{E}_{y\sim\pi_\theta}\left[\log\frac{\pi_\theta(y\mid x)}{\pi(y\mid x,c)}\,\nabla_\theta\log\pi_\theta(y\mid x)\right]$$(2a)

第二步,按 token 近似。$\log\pi(y\mid x)=\sum_t\log\pi(y_t\mid y_{\lt t},x)$。论文在每个位置只保留该位置的 KL,并对整个词表 $\mathcal{V}$ 精确求和(analytic per-token estimator):

$$g=\mathbb{E}_{y\sim\pi_\theta}\sum_t\sum_{y_t\in\mathcal{V}}\pi_\theta(y_t\mid y_{\lt t},x)\,\log\frac{\pi_\theta(y_t\mid y_{\lt t},x)}{\pi(y_t\mid y_{\lt t},x,c)}\,\nabla_\theta\log\pi_\theta(y_t\mid y_{\lt t},x)$$(2)

(2) 不等于 (2a):它丢掉了 $y_t$ 对后续 token 比值的影响,等价于在固定的学生前缀上最小化 $\sum_t D_{\mathrm{KL}}$。这就是附录 A.1 所说的“序列层面有偏”。

  • 监督信号稠密:每个 token、覆盖整个词表;每个问题只需一次 rollout,而 GRPO 类方法每条轨迹只有一个 advantage,且需要一组采样。
  • 理论上应使用 reverse KL,但实践中 forward KL 效果最好;仓库 README(2026-04-07)说明论文所有结果都使用 per-token forward KL。

算法与关键设计选择

以下每项要么在附录中做了 ablation,要么是所有主实验的默认设置。

算法 1(SDFT)

初始化教师参数 $\phi\leftarrow\theta$
对每个训练步:
从示范数据采样 minibatch $\{(x_i,c_i)\}$
对每一对并行执行:
$y_i\sim\pi_\theta(\cdot\mid \mathrm{Ctx}_S(x_i))$ — on-policy rollout
$\ell^S_{i,t}\leftarrow\log\pi_\theta(y_{i,t}\mid y_{i,\lt t},\mathrm{Ctx}_S(x_i))$
$\ell^T_{i,t}\leftarrow\log\pi_\phi(y_{i,t}\mid y_{i,\lt t},\mathrm{Ctx}_T(x_i,c_i))$
$g\leftarrow$ 对 $i$ 平均的 analytic per-token KL 梯度
必要时用 importance sampling 修正推理引擎与训练代码的差异
$\theta\leftarrow\theta-\eta\,g$
$\phi\leftarrow\alpha\,\theta+(1-\alpha)\,\phi$ — EMA 教师

教师参数(附录 A.3)

  • 冻结的基座模型:稳定,但效果较差,因为它反映不了学生学到的进步。
  • 直接用当前学生:不稳定;微小波动经 on-policy 回路放大,训练发散。
  • 学生参数的 EMA($\alpha\in\{0.01,0.02,0.05\}$):跟踪进步并平滑更新。默认选择。

KL gradient estimator(附录 A.1)

  • Sampled token-level estimator:方差更高,KL 控制更弱。
  • Analytic per-token estimator(每步对词表求和):在序列层面有偏,但最稳定、效果最好。默认选择。
  • Rao-Blackwellized estimator(无偏):额外开销换不来可测的提升。
  • 每个问题多次 rollout:收益可忽略,计算量大增。

抑制 artifacts(§5)

学生可能学到教师的措辞,如 “Based on the text…”。对前几个 token 屏蔽损失即可去除,且不损害准确率。

SDFT 即 inverse RL:示范定义了一个隐式奖励

在一个假设下,自蒸馏等价于 on-policy RL,其奖励由模型自身的 ICL 能力给出。

推导(§3.1)

  1. Trust-region RL 一步更新($\pi_k=\pi_{\theta_k}$ 为当前学生,$\pi$ 遍历所有策略):
    $$\pi_{k+1}=\arg\max_{\pi}\ \mathbb{E}_{y\sim\pi}\big[r(y,x)\big]-\beta\,D_{\mathrm{KL}}\big(\pi(\cdot\mid x)\,\|\,\pi_k(\cdot\mid x)\big)$$(3)
  2. 闭式最优解是 tilted distribution $\pi^*_{k+1}(y\mid x)\propto\pi_k(y\mid x)\,e^{r(y,x)/\beta}$,因此
    $$r(y,x)=\beta\big[\log\pi^*_{k+1}(y\mid x)-\log\pi_k(y\mid x)\big]+C$$
  3. In-context assumption:以示范为条件的同一模型(参数 $\theta_k$)近似未知的最优策略
    $$\pi^*_{k+1}(y\mid x)\approx\pi(y\mid x,c)$$(4)
  4. 隐式奖励(去掉 $\beta$ 和 $C$)及其 per-token 形式,后者求和即为前者:
    $$r(y,x,c)=\log\frac{\pi(y\mid x,c)}{\pi_k(y\mid x)},\qquad r_t=\log\frac{\pi(y_t\mid y_{\lt t},x,c)}{\pi_k(y_t\mid y_{\lt t},x)}$$(5)
  5. Policy gradient (在 $\theta=\theta_k$ 处求值,奖励固定)
    $$\nabla_\theta J\big|_{\theta_k}=\mathbb{E}_{y\sim\pi_k}\left[\log\frac{\pi(y\mid x,c)}{\pi_k(y\mid x)}\,\nabla_\theta\log\pi_\theta(y\mid x)\big|_{\theta_k}\right]$$(6)
    恰好等于式 (2a) 在 $\theta=\theta_k$ 处取负:最大化该奖励即最小化 reverse KL。实际使用的式 (2) 是 (2a) 的 per-token 近似。

解读

  • 学生被奖励去靠近“更聪明的”、看过示范的自己。
  • 不需要奖励模型,也不需要奖励先验:先验就是预训练模型的 ICL 能力。
  • Trust-region 项解释了“锚定”:目标是离当前模型最近的高奖励策略。这正是抗遗忘论证的起点(见下两页)。

注意

这一等价关系针对 reverse KL。论文报告的实验实际使用 forward KL,因此 IRL 论证是方法的动机,而不是对实际运行的损失的精确描述。

为什么能抗遗忘(一):理想目标是“解决任务的最小改动”

论文没有给出遗忘的上界;它的论证由三步串联而成,其中只有第一步是严格的数学。

① Trust-region 最优解 = 最小 KL 改动 数学tilted distribution 是达到给定奖励时离 $\pi_k$ 最近的策略。
+
② 示范条件教师 ≈ 该最优解 假设$\pi(\cdot\mid x,c)\approx\pi^*_{k+1}$,且同样靠近 $\pi_k$。
+
③ 新任务上 KL 小 ⇒ 遗忘少 经验规律来自 RL's Razor 等先前工作,本文未推导。

① 最优解的“最小改动”性质

“要高奖励,又不要离 $\pi_k$ 太远”有两种写法。式 (3) 给改动定一个价格 $\beta$;也可以给奖励定一个及格线 $v$,在及格的策略里挑改动最小的:

$$\min_{\pi}\ D_{\mathrm{KL}}\big(\pi\,\|\,\pi_k\big)\quad\text{s.t.}\quad\mathbb{E}_{y\sim\pi}\big[r(y,x)\big]\ge v$$

取 $v$ 为式 (3) 的最优解 $\pi^*_{k+1}=\pi_k\,e^{r/\beta}/Z$ 自身的平均奖励 $v=\mathbb{E}_{\pi^*_{k+1}}[r]$($Z=\sum_y\pi_k(y\mid x)\,e^{r(y,x)/\beta}$ 为归一化常数),两种写法的答案相同。对 $\pi^*_{k+1}$ 的定义取对数,得 $\log\frac{\pi^*_{k+1}}{\pi_k}=\frac{r}{\beta}-\log Z$。对任意 $\pi$:

$$\begin{aligned}D_{\mathrm{KL}}(\pi\,\|\,\pi_k)&=\mathbb{E}_{\pi}\Big[\log\frac{\pi}{\pi_k}\Big]&&\text{KL 的定义}\\&=\mathbb{E}_{\pi}\Big[\log\frac{\pi}{\pi^*_{k+1}}\Big]+\mathbb{E}_{\pi}\Big[\log\frac{\pi^*_{k+1}}{\pi_k}\Big]&&\text{分子分母同乘 }\pi^*_{k+1}\\&=D_{\mathrm{KL}}(\pi\,\|\,\pi^*_{k+1})+\mathbb{E}_{\pi}\Big[\frac{r}{\beta}-\log Z\Big]&&\text{第一项即 KL;第二项代入上式}\\&=\underbrace{D_{\mathrm{KL}}(\pi\,\|\,\pi^*_{k+1})}_{\ge 0,\ =0\iff\pi=\pi^*_{k+1}}+\frac{\mathbb{E}_{\pi}[r]}{\beta}-\log Z&&Z\text{ 与 }y\text{ 无关}\end{aligned}$$

令 $\pi=\pi^*_{k+1}$:第一项为 0,得 $D_{\mathrm{KL}}(\pi^*_{k+1}\,\|\,\pi_k)=v/\beta-\log Z$。及格的 $\pi$ 满足 $\mathbb{E}_\pi[r]\ge v$,于是 $D_{\mathrm{KL}}(\pi\,\|\,\pi_k)\ge 0+v/\beta-\log Z=D_{\mathrm{KL}}(\pi^*_{k+1}\,\|\,\pi_k)$,等号仅当 $\pi=\pi^*_{k+1}$:在所有达到同样奖励的策略中,$\pi^*_{k+1}$ 离 $\pi_k$ 最近(标准的 I-projection 结论,论文只给出闭式解)。

①′ 最优解的两个推论

  • 只对 $\pi_k$ 已有的输出重新加权:$\pi_k(y\mid x)=0\Rightarrow\pi^*_{k+1}(y\mid x)=0$。
  • $\beta$ 越大,改动的价格越高,对应的及格线 $v$ 越低,改动越小。

② 教师近似最优解:两个条件(§3.2)

  • 最优性:教师采样达到接近最大的奖励
    $$\mathbb{E}_{y\sim\pi(\cdot\mid x,c)}\big[r(y,x)\big]\approx\mathbb{E}_{y\sim\pi^*_{k+1}}\big[r(y,x)\big]$$
  • 最小偏离:教师与 $\pi_k$ 的距离和最优解一样近
    $$D_{\mathrm{KL}}\big(\pi(\cdot\mid x,c)\,\|\,\pi_k\big)\approx D_{\mathrm{KL}}\big(\pi^*_{k+1}\,\|\,\pi_k\big)$$
  • 第二个条件承担抗遗忘的论证:教师与学生参数相同,只差上下文,所以输出保持模型自己的风格。照抄示范的教师会违反这一条件。
  • 实测(ToolAlpaca):教师准确率 100%(基座 42%);到基座的 KL 为 0.68 nats,而 SFT 模型为 1.26,新任务准确率相同。
检验假设:教师既正确,又靠近基座模型

Qwen2.5-7B-Instruct,ToolAlpaca:模型拿到工具 API 说明和用户请求,需要给出正确的工具调用。

条件一:最优性

ToolAlpaca 准确率(%)

基座,无示范
42
教师(+示范)
100
  • 作者人工检查了 50 条教师推理轨迹:最终工具调用全部正确,且中间推理有效、有依据。
  • 说明教师是在重建推理过程,而非照抄示范的输出。

条件二:最小偏离

到基座策略的 KL 散度 $D_{\mathrm{KL}}(\pi\,\|\,\pi_0)$,单位 nats(越低越近)

SFT 模型
1.26
教师
0.68

坐标轴 0–1.5 nats。

  • 教师达到与 SFT 相同的新任务准确率,但偏离基座的程度只有约一半(图 2 右)。
  • 这里用 $\pi_0$ 代替训练中的 $\pi_k$ 作为参照。
  • 两项检验都是经验性的,且只在一个任务上做;论文没有从理论上验证该假设。

为什么能抗遗忘(二):从“KL 小”到“遗忘少”,以及论证的缺口

第三步依赖先前工作的经验规律;推导本身与实际训练之间也有几处出入。

③ 经验规律(RL's Razor 等)

作者先前的工作(Shenfeld 等 2025)及 Chen 等 2025 发现:遗忘程度随微调后策略与基座策略在新任务输入上的 KL 散度增大而增大,

$$\text{遗忘}\ \uparrow\quad\text{随}\quad\mathbb{E}_{x\sim\mathcal{D}_{\text{new}}}\,\mathrm{KL}\big(\pi_0(\cdot\mid x),\,\pi(\cdot\mid x)\big)\ \uparrow$$

并且 on-policy 训练会倾向于选择 KL 较小的解,而 SFT 不会。

这是相关性规律,不是定理;本文直接引用,未重新推导。

直观对比:两种梯度

SFT 在专家前缀上提高专家 token 的概率:

$$\nabla\mathcal{L}_{\text{SFT}}=-\,\mathbb{E}_{(x,y^\star)\sim\mathcal{D}}\sum_t\nabla_\theta\log\pi_\theta(y^\star_t\mid y^\star_{\lt t},x)$$

若 $\pi_\theta(y^\star_t\mid\cdot)$ 很小,梯度会强行搬动大量概率质量,参数改动也会波及无关输入。

SDFT 在学生自己的前缀 $y\sim\pi_\theta$ 上,向同一模型给出的分布 $\pi(\cdot\mid y_{\lt t},x,c)$ 靠拢:目标本就在模型自身的分布附近,所需改动更小。

论证的缺口

  • KL 方向:推导针对 reverse KL,实际运行用的是 per-token forward KL,IRL 论证并不覆盖实际损失。
  • Estimator:analytic per-token estimator 在序列层面有偏(附录 A.1),又一处偏离。
  • EMA 教师:推导假设教师基于 $\pi_k$;EMA 教师滞后于学生,目标只是近似。
  • 证据薄弱:“最小偏离”只靠一个任务上的一组数字(0.68 vs 1.26),且参照的是 $\pi_0$ 而非各步的 $\pi_k$。
  • 没有对旧任务的保证:KL 在新任务的输入上测量,对其他输入上的表现没有任何界。
  • 遗忘仍然存在:Science Q&A 训练后 IFEval 从 74.3 降到 66.8,只能说“遗忘更少”。

实验设置

两类后训练适应:学习新技能,以及吸收新事实。

技能学习

选择模型未专门调优过的任务(不同于数学、代码)。

  • Science Q&A:SciKnowEval 化学 L-3 子集,多选题,75/5/20 划分。示范由 GPT-4o 生成,保留答案正确的一条(每题最多采样 8 次)。
  • Tool Use:ToolAlpaca,沿用原始划分与示范。用正则匹配 API 调用评分,允许参数顺序不同。
  • Medical:HuatuoGPT-o1。约 2 万条英文 SFT 数据用于训练;1,000 道可验证题用于评测,由 GPT-5-mini 判分。

知识获取

  • 约 20 万 token 的维基百科文章,内容为 2025 年的自然灾害,在模型知识截止之后(缅甸和堪察加地震、飓风 Melissa、得州中部洪水等)。
  • 用 GPT-5 从文章生成问答对,规模约为原文的 5 倍。
  • 指标:strict(所有细节正确)、lenient(包含正确信息且无错误)、OOD:需要这些事实但不直接提及的间接问题(如“2025 年哪些国家需要国际人道主义援助?”)。

旧能力

HellaSwag、TruthfulQA、MMLU、IFEval、Winogrande、HumanEval 的平均分(lm-eval-harness),作为遗忘的度量。

基线

  • 技能:SFT;DFT(用 importance sampling 把 offline 数据当作 on-policy 样本);SFT + Re-invocation(SFT 后在通用 prompt 上从基座做 on-policy 蒸馏以恢复能力)。
  • 知识:在原文上 continual pretraining(CPT);在问答上 SFT;总能检索到正确文章的 oracle RAG。

流程

全参数微调,TRL,单张 H200。每种方法分别搜索 learning rate、batch size、epoch 数,报告验证集最优的 checkpoint。greedy decoding,3 个 seed。SDFT max generation length 2048(技能)或 1024(知识)。

技能学习:SDFT 学得更多,几乎不遗忘

在三个任务上,它都是唯一一个提升新任务、且旧能力没有明显下降的方法。

Science Q&A

新任务准确率(%)

SFT
66.2
SFT+re-invoke
66.0
DFT
54.8
SDFT
70.2

旧任务平均分(%)

SFT
53.4
SFT+re-invoke
60.2
DFT
60.2
SDFT
64.5

Tool Use

新任务准确率(%)

SFT
63.2
SFT+re-invoke
63.1
DFT
64.2
SDFT
70.6

旧任务平均分(%)

SFT
56.0
SFT+re-invoke
63.7
DFT
60.8
SDFT
65.4

Medical

新任务准确率(%)

SFT
35.5
SFT+re-invoke
35.6
DFT
36.2
SDFT
40.2

旧任务平均分(%)

SFT
60.2
SFT+re-invoke
62.6
DFT
64.0
SDFT
65.4

SFT 在哪里遗忘:指令遵循、真实性与代码

在各任务上训练后,每个旧基准的得分。红色表示比基座下降超过 5 分。

训练任务 → 方法新任务HellaSwagHumanEvalIFEvalMMLUTruthfulQAWinogrande平均
基座(Qwen2.5-7B-Instruct)—62.065.874.371.747.971.165.5
Science Q&A(基座 32.1)
SFT66.255.054.835.364.636.873.753.4
SFT + re-invoke66.061.663.452.968.745.270.060.2
DFT54.857.667.060.469.438.868.260.2
SDFT70.260.968.966.870.746.573.164.5
Tool Use(基座 42.9)
SFT63.257.350.049.870.237.573.156.0
SFT + re-invoke63.161.768.959.171.549.171.663.7
DFT64.259.761.460.271.640.271.560.8
SDFT70.661.668.371.971.547.371.765.4
Medical(基座 30.1)
SFT35.559.562.156.670.539.872.960.2
SFT + re-invoke35.661.563.167.670.042.371.462.6
DFT36.261.964.674.671.640.171.364.0
SDFT40.261.467.772.371.547.371.965.4

观察

  • IFEval 最脆弱:Science Q&A SFT 使其从 74.3 降到 35.3。SDFT 的最差情况是 66.8,同样出现在 Science Q&A 之后。
  • TruthfulQA 在每个任务上经 SFT 和 DFT 后下降 7.7–11.1 分;SDFT 的下降不超过 1.4 分。
  • Re-invocation 恢复了 SFT 的大部分损失,但始终达不到基座平均分,且需要额外一个训练阶段。
  • DFT(近似 on-policy)遗忘少于 SFT,但 TruthfulQA 仍下降,Science Q&A 准确率也低得多。
  • 每个任务的 SFT 都让 Winogrande 略有提升。

依次学习三个技能:SDFT 逐步累积,SFT 学一个忘一个

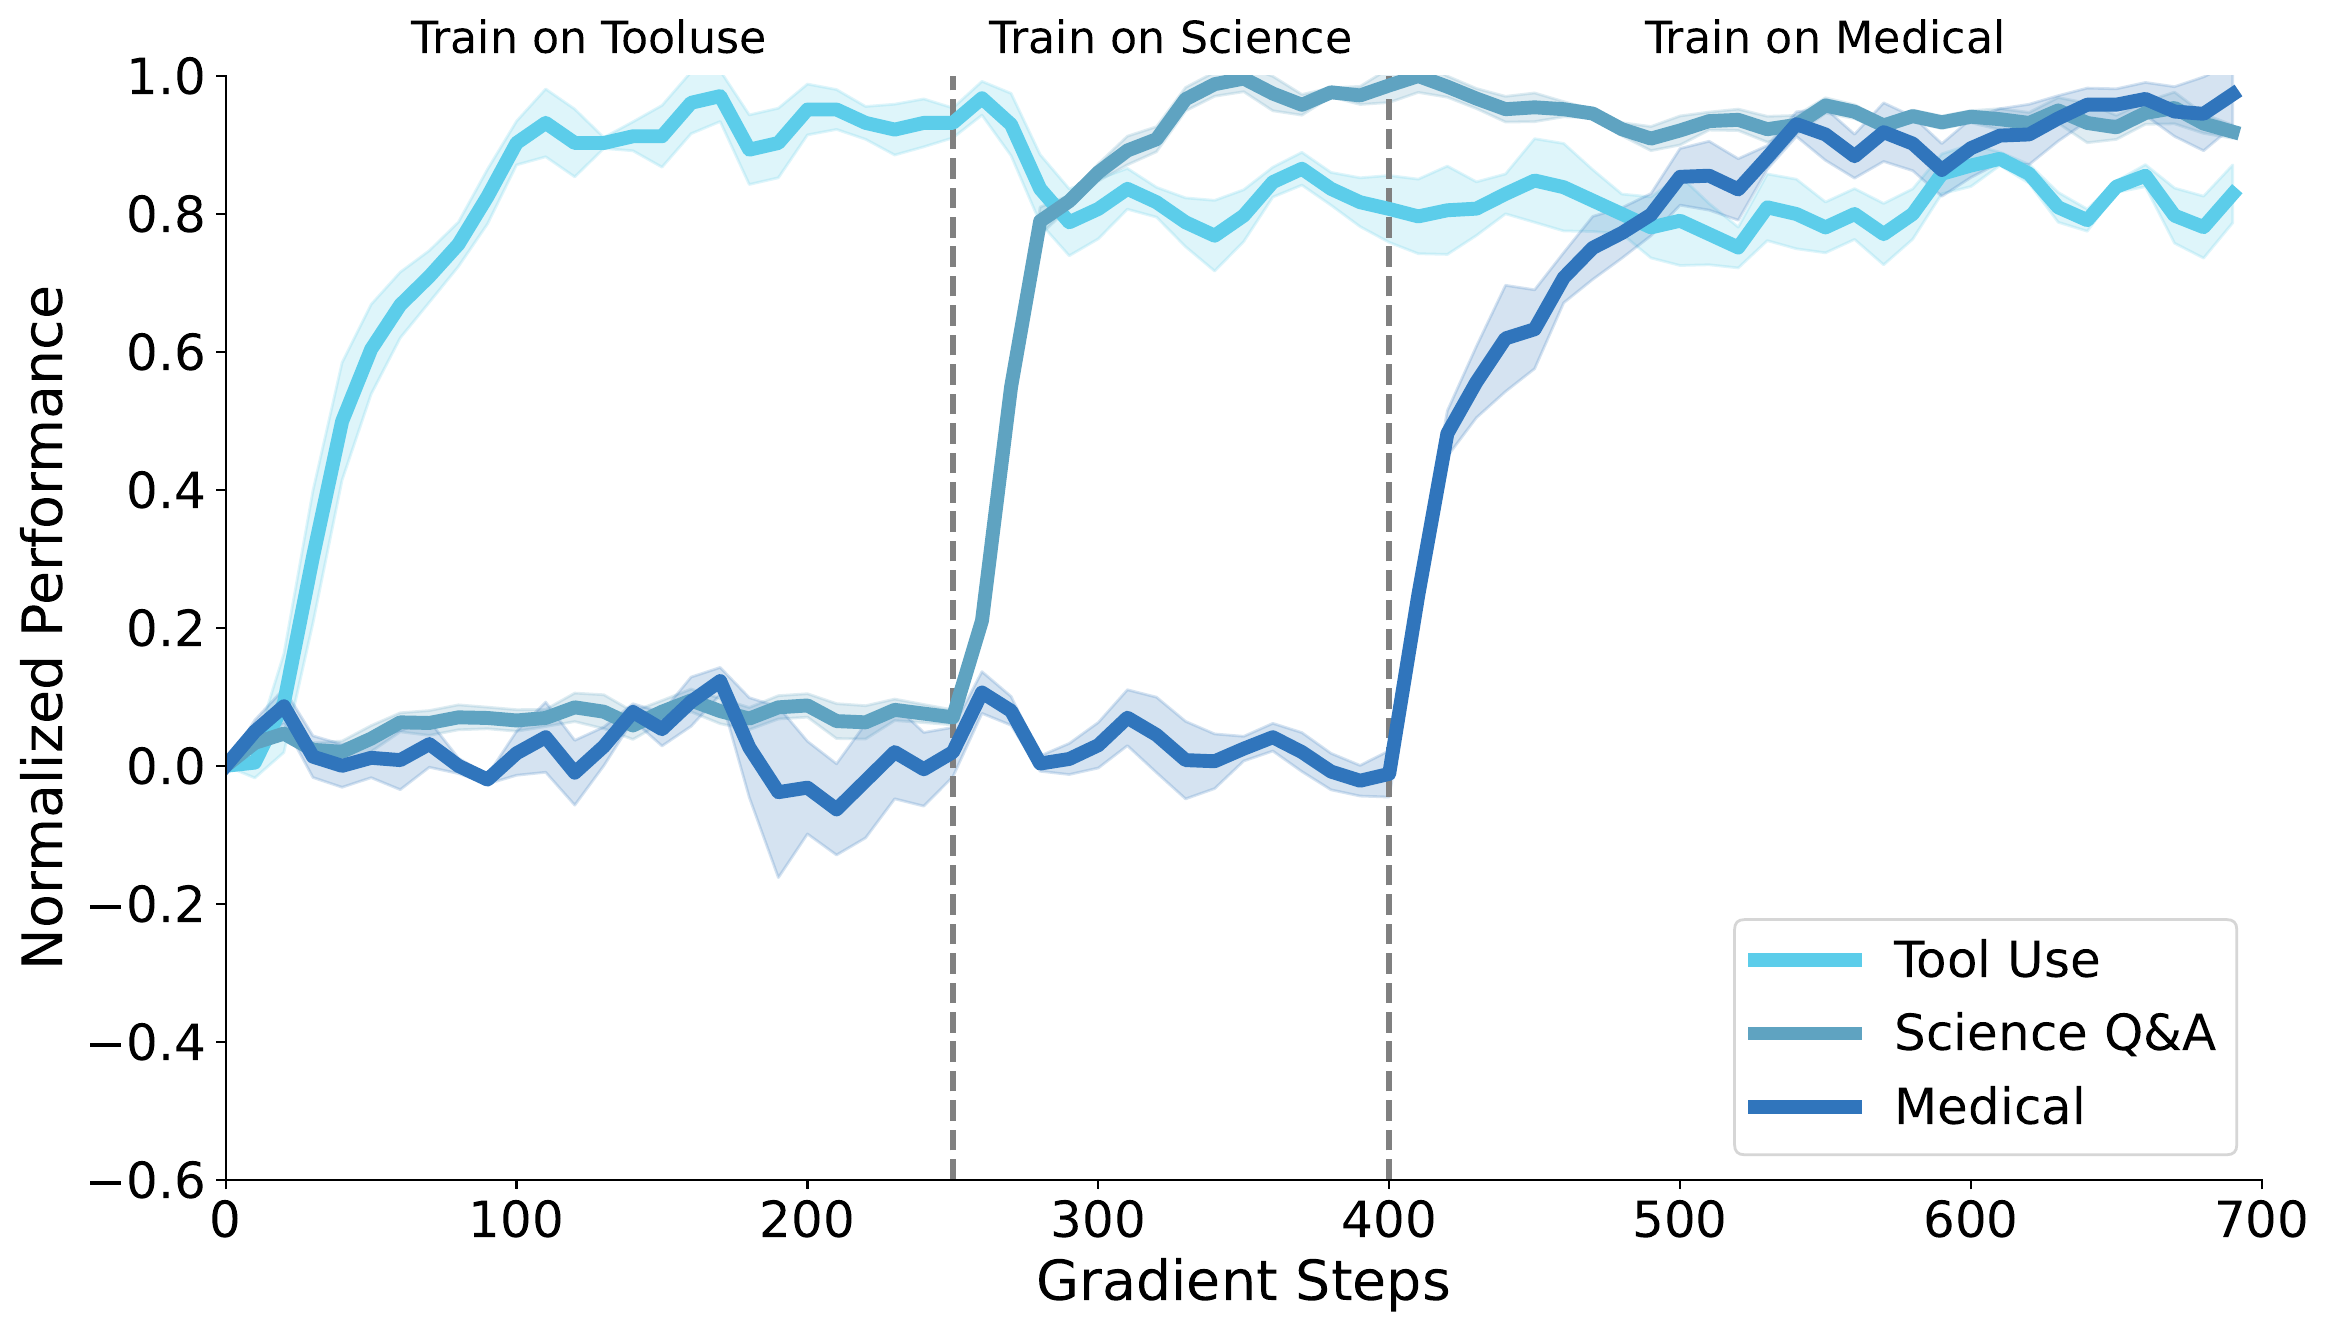
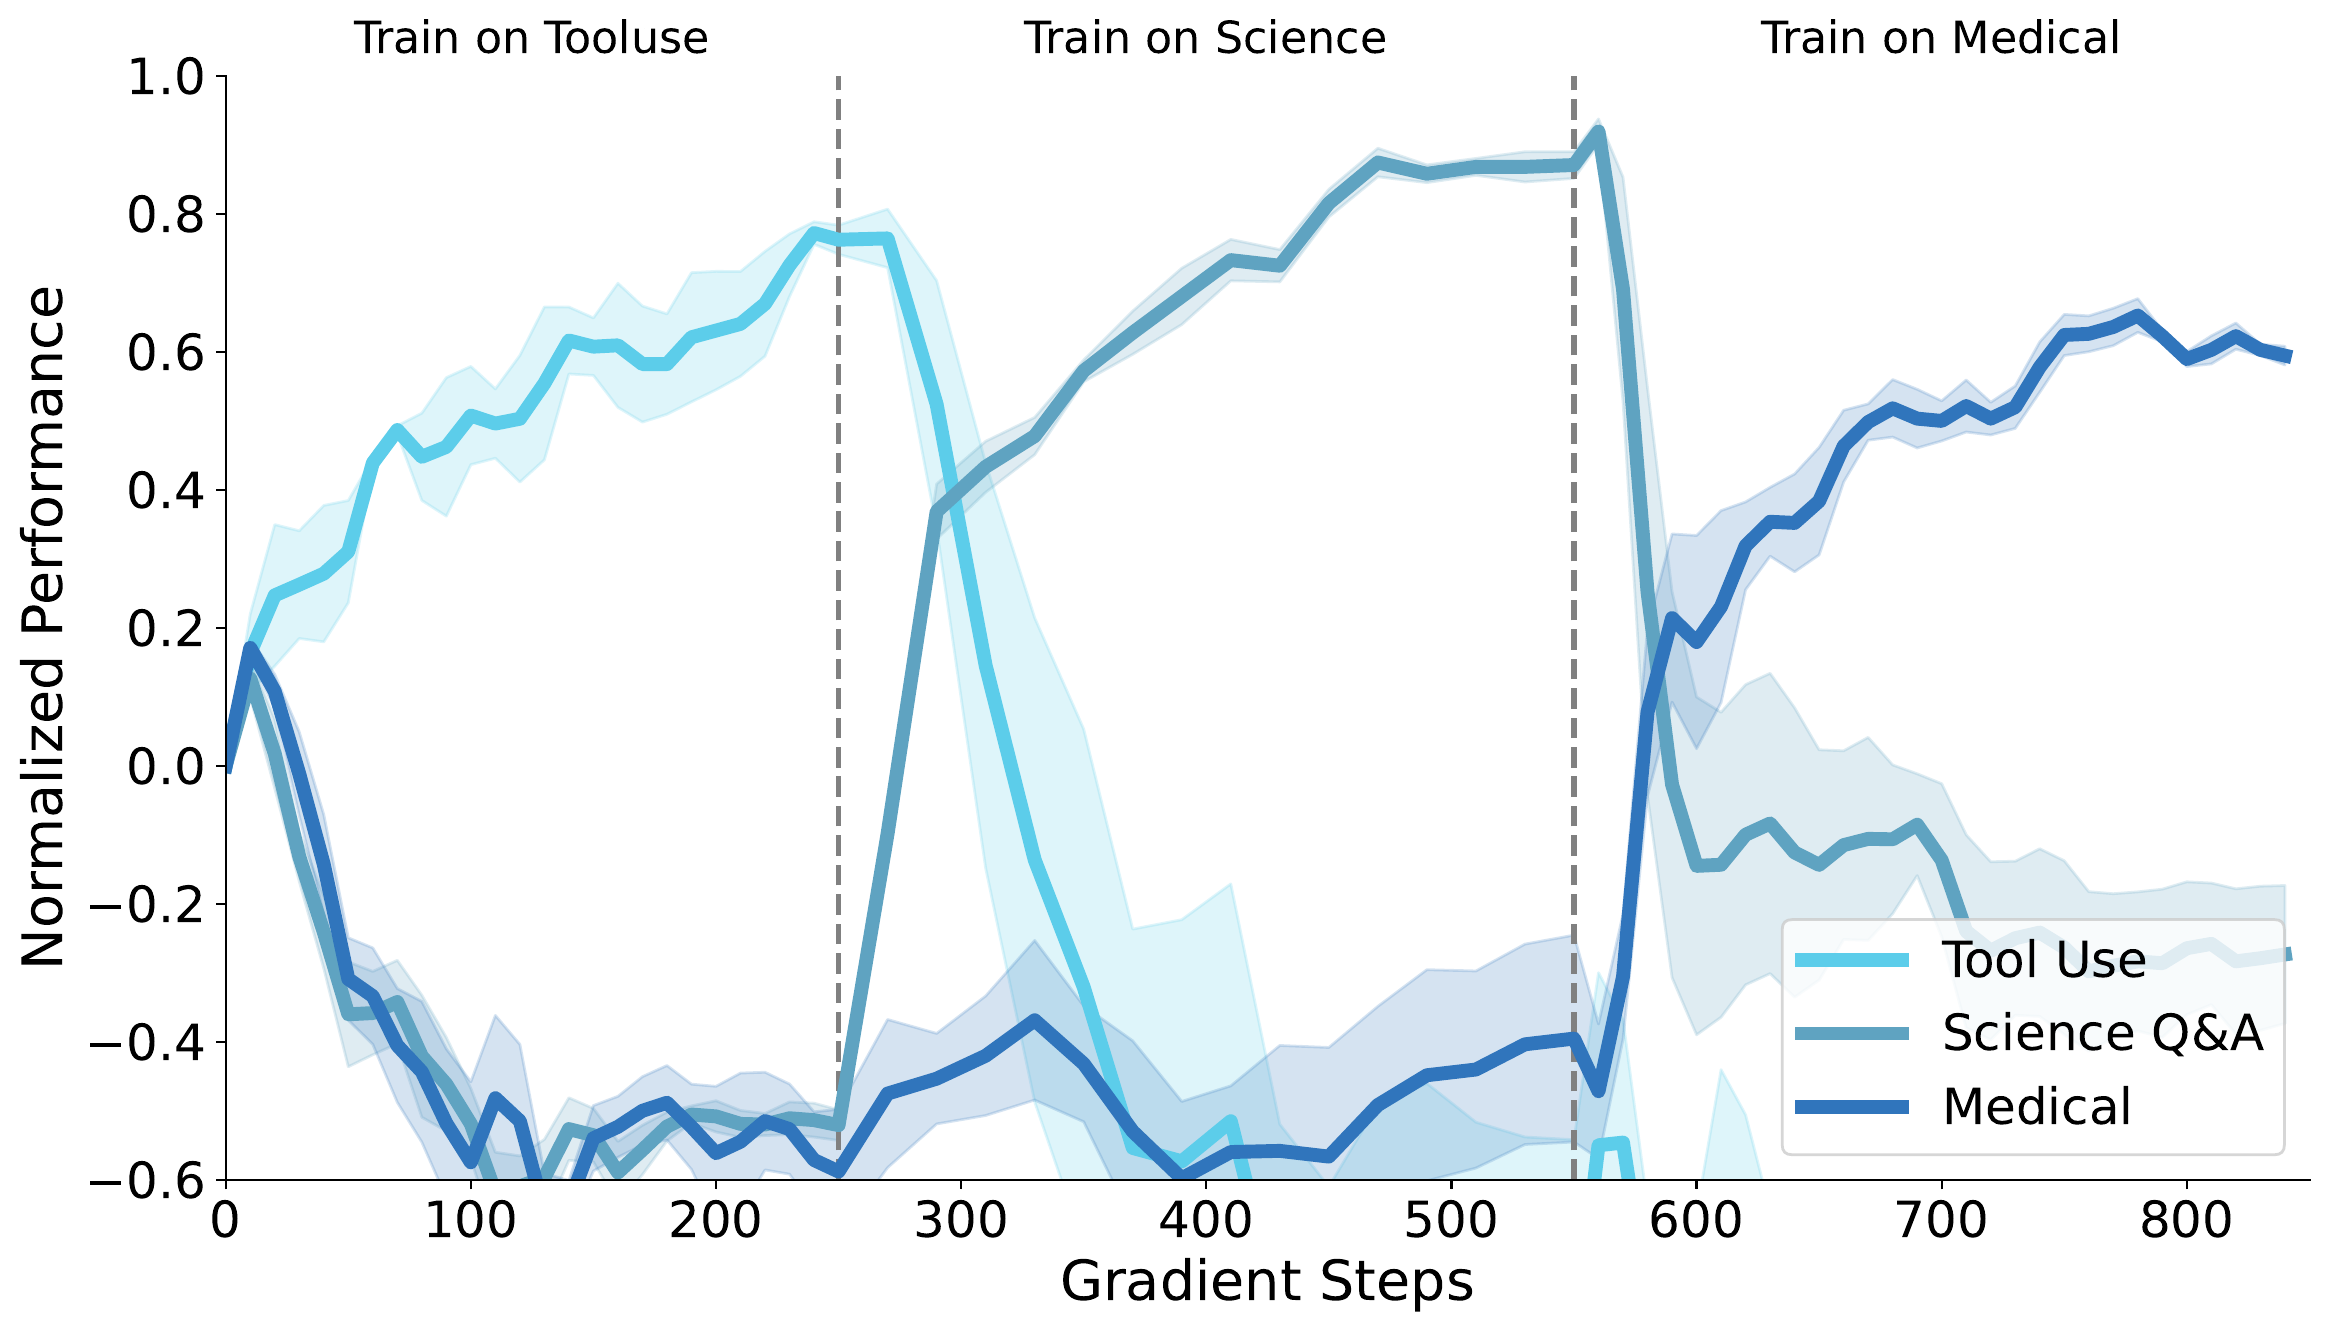
同一个模型依次在 Tool Use → Science Q&A → Medical 上训练。每个任务分别归一化:0 = 基座模型,1 = 两种方法中达到的最高准确率。

论文图 3a:SDFT 顺序学习曲线
论文图 3a,SDFT。每进入一个新阶段,新任务曲线上升,之前的任务曲线基本保持在高位。
论文图 3b:SFT 顺序学习曲线
论文图 3b,SFT。切换到下一个任务后,前一个任务迅速跌到基座以下(归一化值为负)。

论文只给出曲线,没有各阶段结束时的数值表;阴影为不同 seed 的波动范围。注意归一化以“两种方法的最好成绩”为 1,图上的高低只在同一任务内可比。

模型规模与 pass@k:需要足够强的 ICL,提升不是靠变尖锐

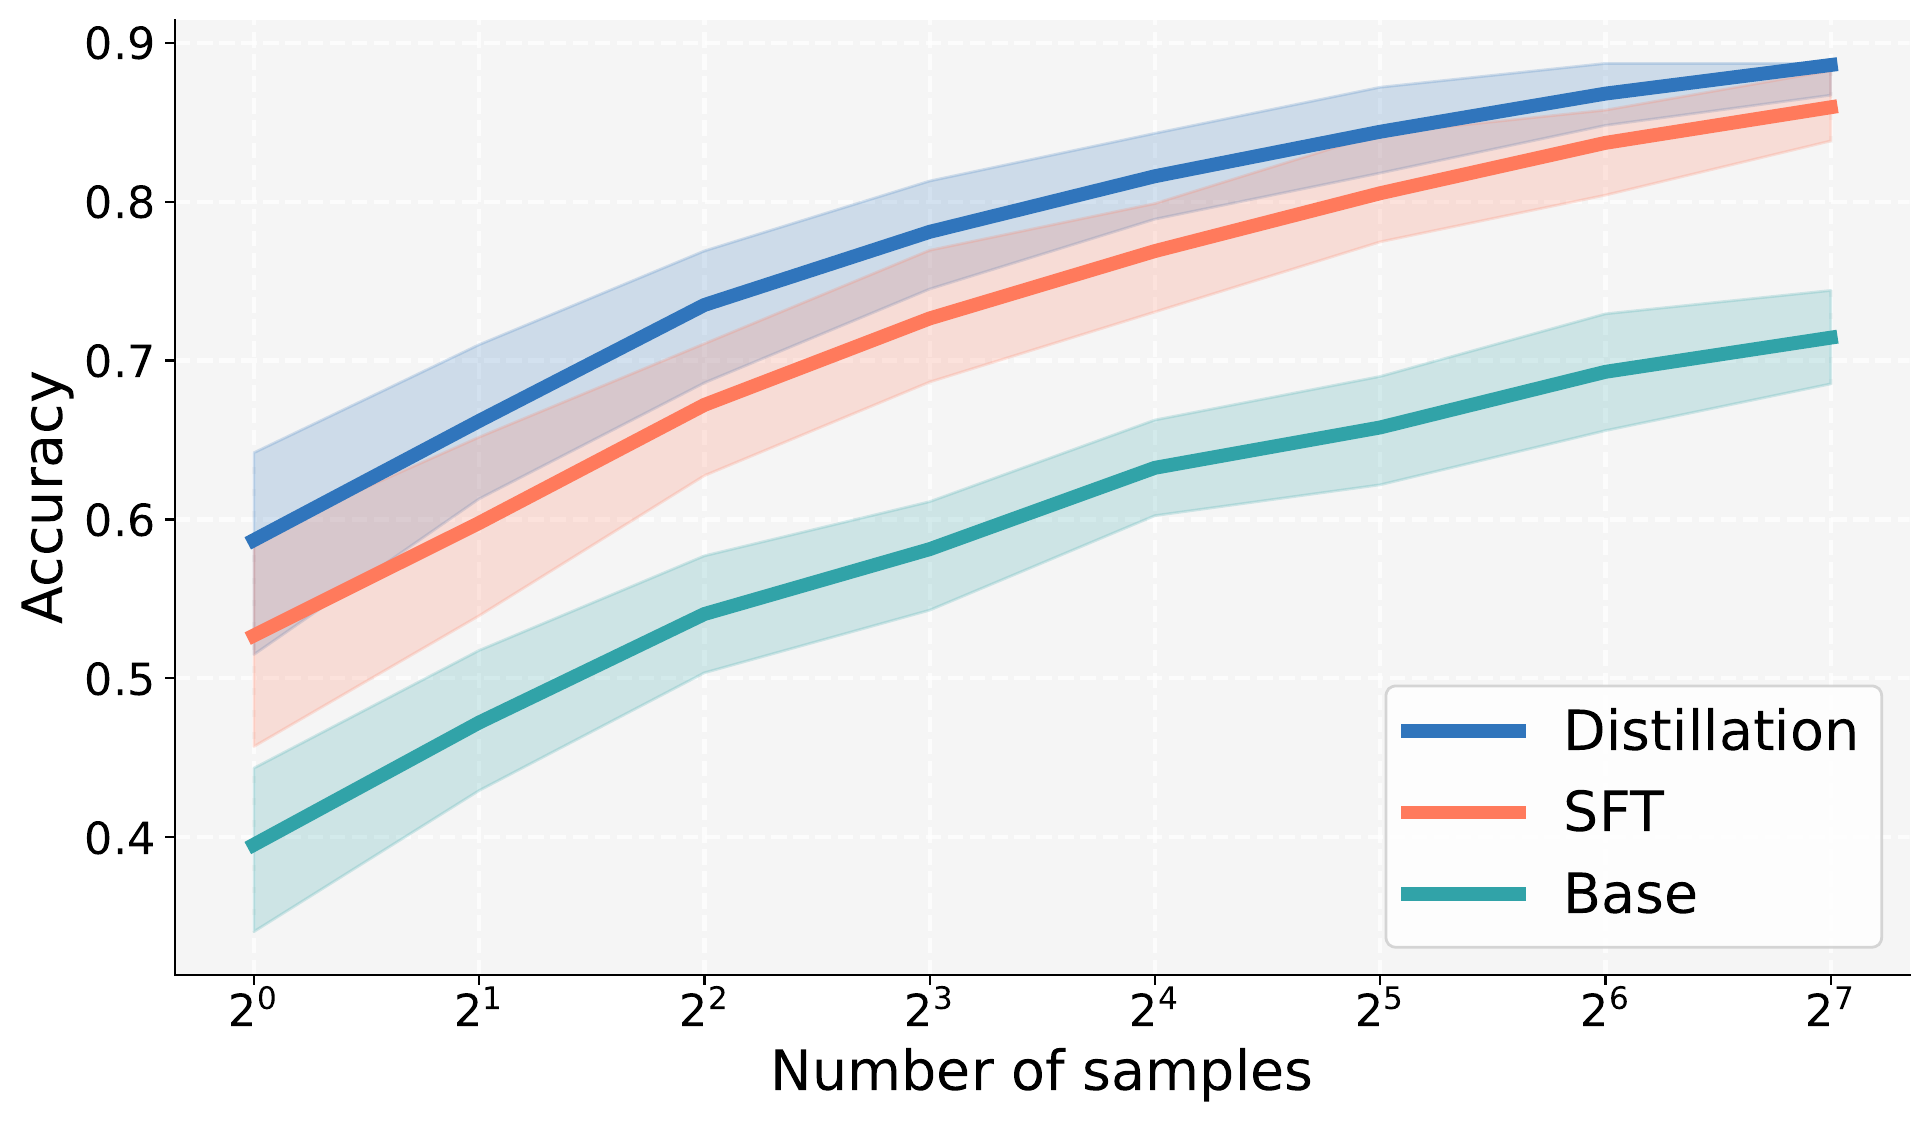
规模实验在 Science Q&A 上,pass@k 在 Tool Use 上(temperature 1.0,top-p 0.95)。

模型规模(图 5 左)

Science Q&A 上 SDFT 减 SFT(分)

Qwen2.5-3B
−3.3
Qwen2.5-7B
+4.0
Qwen2.5-14B
+6.9

坐标轴 −14 到 +14;竖线为 0。论文正文只给出差值。

  • 3B 时教师的 ICL 太弱,SDFT 不如 SFT。
  • 差距随规模增大;作者预期更大的模型收益更多。
  • 只在一个任务、一个模型家族上测了三个规模。

pass@k(图 5 右)

论文图 5 右:Tool Use 上的 pass@k
论文图 5 右。$k$ 从 1 到 128,SDFT(Distillation)始终高于 SFT 和基座,且差距不随 $k$ 增大而消失。常有人怀疑 RL 只是通过降低熵提升 pass@1(Yue 等 2025);这里的结果不支持这种解释。

知识获取:SDFT 几乎追平 oracle 检索

基座模型对这些 2025 年事实一无所知;SDFT 吸收它们的方式能迁移到间接问题上。

结果(表 1)

方法StrictLenientOOD
基座000
在文章上 continual pretraining(CPT)9377
在问答上 SFT809580
SDFT8910098
Oracle RAG(upper bound 参照)91100100
  • CPT 几乎无效,与 Mecklenburg 等 2024 一致。
  • SFT strict 准确率 80,但 OOD 仍只有 80:它学会复述答案,而没有把事实融入知识。
  • SDFT strict 89,OOD 98。

教师需要看到什么(附录 A.2)

固定 on-policy 训练、改变教师上下文时的 strict 准确率(%)

只看答案
37
只看文章
75
文章 + 答案
89
  • 以往用于知识注入的自蒸馏(Cartridges;Kujanpää 等 2025)只让教师看原始语料,并且 offline 训练。
  • 在教师上下文中加入解答,比只给文章高 14 分。

只用答案数据训练推理模型

在短答案上做 SFT 会压制推理模型的长 CoT。SDFT 的教师就是同一个推理模型,所以目标分布保留了它的推理风格。

Olmo-3-7B-Think,Medical 任务(数据中没有 CoT)

准确率(%)

基座
31.2
+ SFT
23.5
+ SDFT
43.7

坐标轴 0–100。

平均回答长度(token)

基座
4612
+ SFT
3273
+ SDFT
4180

坐标轴 0–5000 token。

结果

  • SFT 降低准确率(31.2 → 23.5),回答缩短 29%,推理深度坍缩。
  • SDFT 准确率提高 12.5 分,保留了原长度的 91%。
  • 回答长度被用作推理深度保留程度的代理指标。

意义

  • 真实数据集常常只有最终答案;闭源模型也不暴露推理过程。
  • SDFT 能在没有推理轨迹的情况下让推理模型适应这类数据。

反方向不成立

作者在 §5 中说明:把非推理模型变成会写显式 CoT 的模型很困难。SDFT 能保持一种生成风格,但不能创造一种新风格。

增益来自哪里:on-policy 训练,而不只是更好的教师

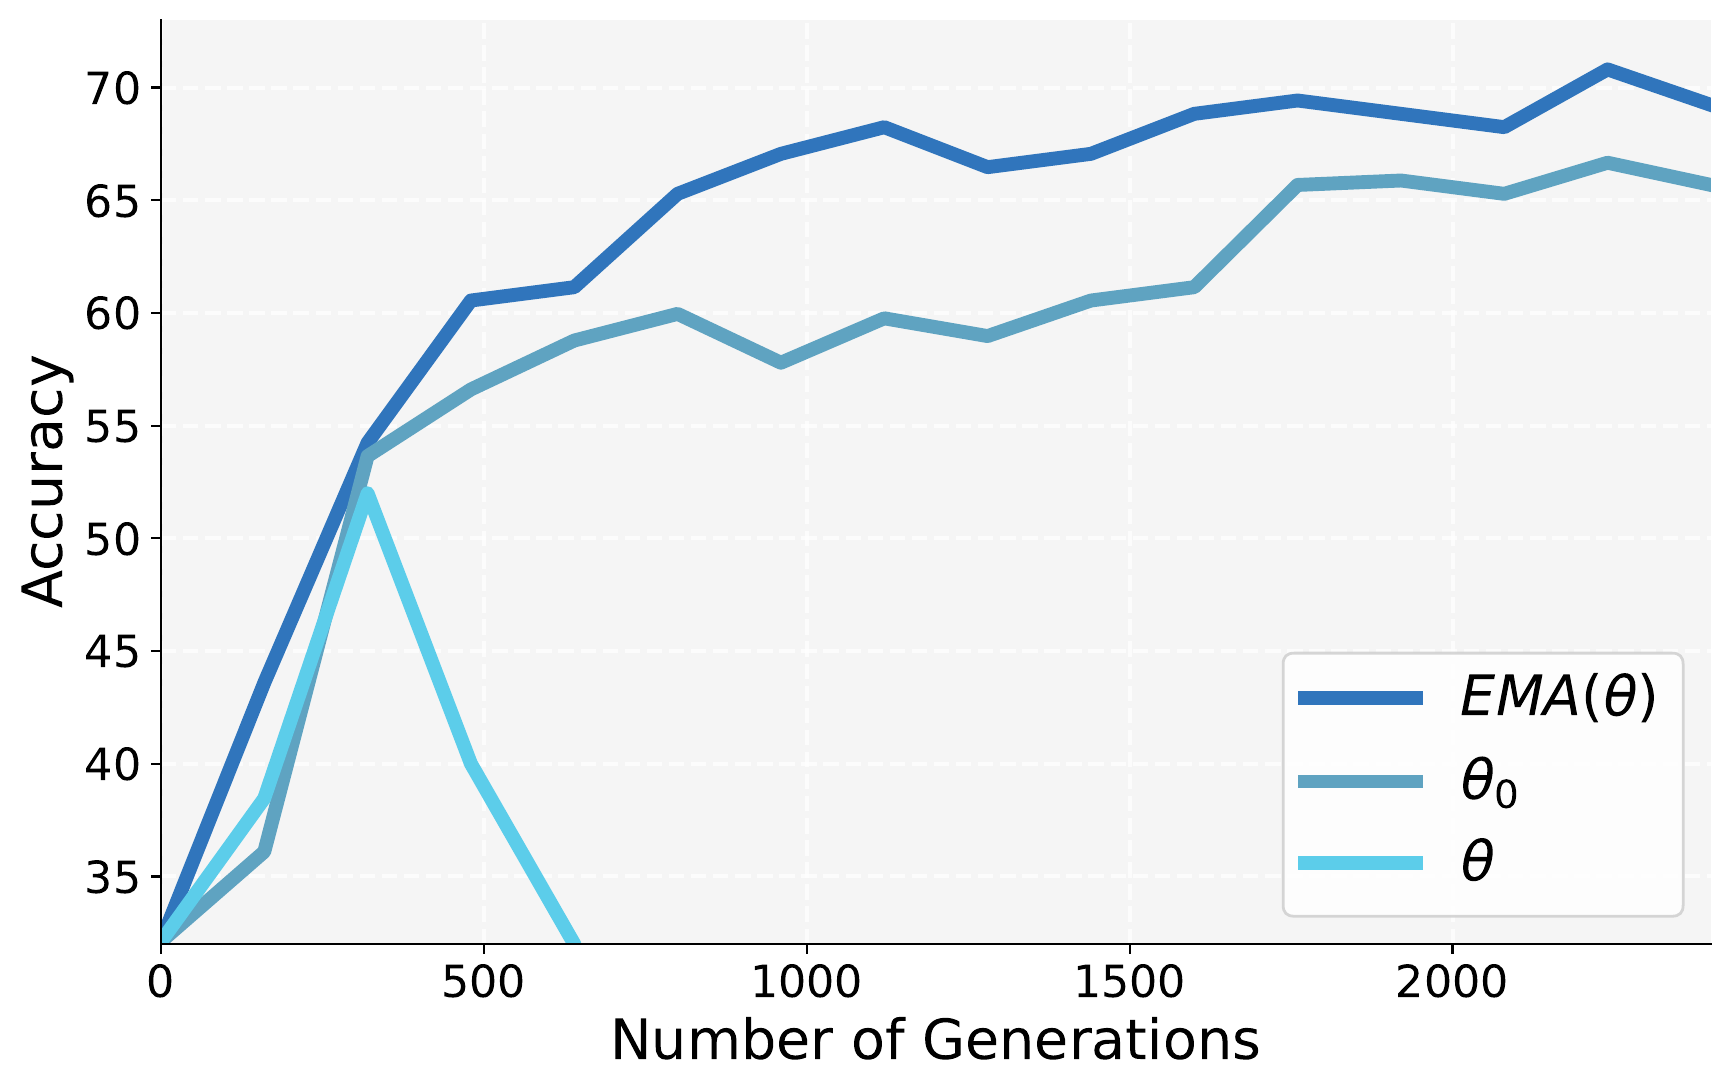
图 6 用同一个示范条件教师比较三种用法;图 8 比较三种教师参数。均在 Tool Use 上。

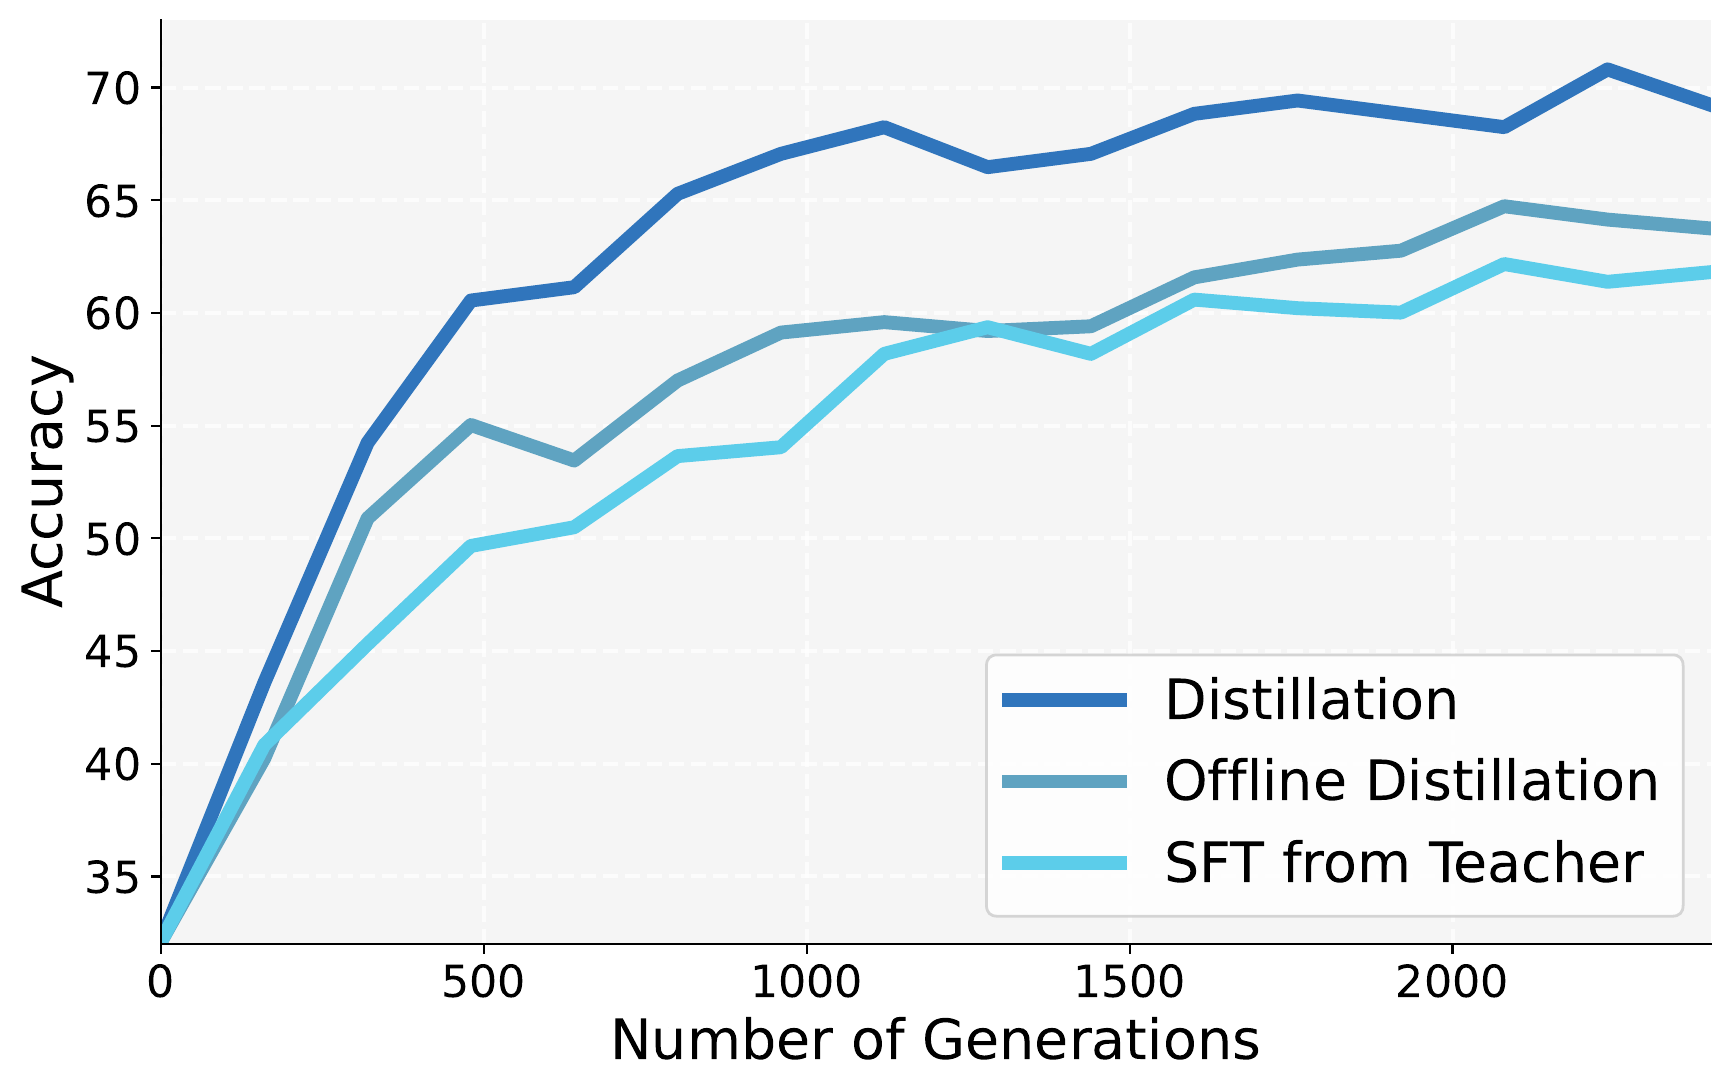
Offline vs on-policy(图 6)

论文图 6:on-policy 与 offline 蒸馏对比
论文图 6。Distillation = SDFT;Offline Distillation = 在固定的教师输出上最小化 KL;SFT from Teacher = 在教师样本上做 SFT。两种 offline 变体在整个训练过程中都低于 SDFT。

教师参数(图 8)

论文图 8:教师参数选择
论文图 8。$\mathrm{EMA}(\theta)$ 最好;冻结基座 $\theta_0$ 稳定但较低;直接用当前学生 $\theta$ 作教师,先上升后在训练中途崩溃。

Ablation 汇总

因素结论
训练分布on-policy > 两种 offline 变体 > SFT
教师参数EMA > 冻结基座;用学生会发散
教师上下文文章 + 答案 89 > 文章 75 > 答案 37
KL estimatoranalytic per-token 最好;Rao-Blackwellized 无收益
每题 rollout1 次足够
KL 方向forward KL 最好(所有结果均使用)
模型规模3B −3.3;7B +4.0;14B +6.9
Epoch 数SDFT 2(技能)/ 4(知识);SFT 1 之后无收益

图 6、8 只有曲线(准确率坐标 35–70),没有列出最终数值。

讨论与局限(作者的陈述)

SDFT 与 on-policy RL 互补:它覆盖的是“有示范、没有奖励”的情形。

与 RL 的关系

  • 监督假设不同:示范而无奖励,vs 有奖励并通过探索优化。
  • 可以结合:用 SDFT 作为 RL 前的初始化(pass@k 的提升支持这一点),或混合两种信号。
  • 每步比 GRPO 便宜:每题一次 rollout,credit assignment 到 token 甚至 logit 级别。

代价与失效模式

  • 计算量:约为 SFT 的 2.5 倍 FLOPs、4 倍 wall-clock 时间。若与“SFT + 恢复阶段”(如 Re-invoke)相比,总时间可能更少。
  • 学到 artifacts:学生会模仿教师的 “Following the example…” 之类措辞;屏蔽前几个 token 是启发式修补。
  • 需要强 ICL:3B 时失效。
  • 只能做小幅行为改变:无法让非推理模型学会写 CoT。
  • 仍有遗忘(如 Science Q&A 后 IFEval 74.3 → 66.8)。

未来工作

  • 与 on-policy RL 结合:先 SDFT 再 RL,或同时混合示范信号与奖励信号。
  • 进一步减少残余的遗忘。
  • 从非专家或带噪声的示范中学习。
  • 从非结构化数据(如用户对话)中学习,面向真实的持续学习场景。

总结:用“看过示范的自己”当教师,把示范变成 on-policy 信号

以下两页是我们的评估,不是论文的陈述。

贡献

SDFT 让模型在只有示范、没有奖励的情况下做 on-policy 学习:学生在自己的 rollout 上,向以示范为条件的同一模型(EMA 权重)蒸馏。在 Qwen2.5-7B 的技能学习和知识注入任务上,它的新任务表现高于 SFT,同时几乎不损失旧能力。

值得记住的结果

  • 学得更多、忘得更少:Tool Use 70.6 vs SFT 63.2;旧任务平均 65.4 vs 56.0(基座 65.5)。
  • 知识真正被整合:新注入事实的 OOD 准确率 98 vs SFT 80,接近 oracle RAG 的 100。
  • 推理模型可用 answer-only 数据:Olmo-3-7B-Think 在 Medical 上 43.7 vs SFT 23.5,回答长度保持 91%。
  • 关键是 on-policy:同一个教师做 offline 蒸馏,始终低于 SDFT(图 6)。
  • 依赖 ICL 能力:3B 时比 SFT 低 3.3,14B 时高 6.9。

证据较强的部分

  • 遗忘的减少很一致:3 个任务 × 6 个旧基准,SDFT 的旧任务平均分最多比基座低 1.0;TruthfulQA 上 SFT、DFT 降 7.7–11.1,SDFT 不超过 1.4(表 5)。
  • 机制被隔离了:图 6 固定教师、只改变训练分布,直接说明增益来自 on-policy,而不只是教师质量。
  • 设计选择都有 ablation:教师上下文(图 7)、教师参数(图 8)、KL estimator(附录 A.1)各自都做了对照。
  • 不只是变尖锐:pass@k 在 $k\le 128$ 上一致领先(图 5 右)。
  • 三个顺序任务上的累积学习曲线与单任务结论一致(图 3)。

评述:理论与实际训练有出入,泛化范围尚未证明

每一条都对应到论文的具体章节。

证据薄弱之处

  • 理论不覆盖实际损失:§3.1 的 IRL 等价针对 reverse KL,而所有结果都用 per-token forward KL(README,2026-04-07);analytic estimator 在序列层面有偏(附录 A.1)。
  • “最小偏离”只有一个数字:0.68 vs 1.26 nats,单一任务,且参照 $\pi_0$ 而非各步的 $\pi_k$(§3.2)。
  • 范围窄:几乎全部是 Qwen2.5-7B;规模实验只在 Science Q&A;推理模型只有 Olmo-3-7B-Think 一个。
  • 计算量未对齐:SDFT 约 2.5 倍 FLOPs,且训练 2–4 epoch;没有等计算量的 SFT 或 RL 对照。
  • 不确定性没有展示:附录 B.2 称报告 3 个 seed 的 95% CI,但表 1、2、5 没有区间。
  • 判分与旧能力度量:Medical 和知识任务由 GPT-5-mini 判分;旧能力套件里没有数学或长推理基准。

开放问题

  • 用 reverse KL(与理论一致)训练,结果是否相同?forward 与 reverse 的直接对比没有报告。
  • 等 FLOPs 预算下,SDFT 对比 SFT 多 epoch、对比 RL(若有奖励)如何?
  • 对 thinking 模型,教师 prompt 会不会改变推理风格并把它蒸馏给学生?
  • 30B 以上、其他模型家族、更长的任务序列上能否保持?
  • 示范有噪声或来自弱模型时,教师是否仍满足“最优性”条件?

我们的思考:抗遗忘靠的是代理指标,锚点还会漂移

左栏是论证的核心局限;右栏是值得验证的方向。

核心局限

  • 代理指标:“遗忘少”的依据是经验相关性:遗忘随微调模型与基座在新任务输入上的 KL 增大而增大(RL's Razor 等)。SDFT 压低的是学生到教师的 KL,再借“教师靠近基座”间接压低这个量。两步都是代理,这是最关键的局限。
  • 测错了地方:新任务输入上的 KL 小,不保证旧任务输入上的 KL 小;而我们真正关心的是后者。参数是共享的,新任务上的小改动可以在别处产生大变化。
  • 锚点在移动:每一步只相对当前策略 $\pi_k$(实现中由 EMA 教师近似)是最小改动,而不是相对基座 $\pi_0$。许多小步串起来,对 $D_{\mathrm{KL}}(\pi_K\,\|\,\pi_0)$ 没有累积上界。

可探索方向

  • 在训练循环里加入任务外锚点。训练 batch 中混入保留 prompt $x\sim\mathcal{D}_{\text{ret}}$:新任务 prompt 照常用 EMA 教师($\mathcal{L}_{\text{SDFT}}$);保留 prompt 没有示范,EMA 教师只是学生的滞后副本,因此锚定到基座 $\pi_0$:
    $$\mathcal{L}=\mathcal{L}_{\text{SDFT}}+\lambda\,\mathbb{E}_{x\sim\mathcal{D}_{\text{ret}},\,y\sim\pi_\theta}\sum_t w_t\,D_{\mathrm{KL}}\big(\pi_\theta(\cdot\mid y_{\lt t},x)\,\|\,\pi_0(\cdot\mid y_{\lt t},x)\big)$$
    直接约束旧输入上的 KL,同时给出一个不随 $k$ 漂移的锚点。需要对照的基线:普通 replay,以及 LwF 式蒸馏。
  • 选择性保留(加分项)。并非基座在保留 prompt 上的每个 token 都值得保留;每个位置的权重 $w_t$ 表示保留力度。启发式:基座越确定的位置权重越高,例如 $w_t=\exp\!\big(-H(\pi_0(\cdot\mid y_{\lt t},x))\big)$。
  • 闭环调节 $\lambda$。每隔固定步数在旧任务上评测,据此调整 $\lambda$ 或保留 prompt 的比例。这是 batch 级的控制,与 token 级的 $w_t$ 互补。
  • 更长的任务序列。在比论文三任务更长的序列上评测,记录遗忘何时出现、出现在哪类能力上。