---
title: "从线性注意力到 Test-Time Training"
author: "konakona"
date: "2026-07-17"
language: "zh-CN"
canonical: "https://blog.konakona.dev/zh/posts/from-linear-attention-to-test-time-training/"
description: "线性注意力将标准注意力的平方复杂度降低为线性,这很好。但我们能做得更好吗?"
translation_en: "https://blog.konakona.dev/en/posts/from-linear-attention-to-test-time-training/"
---
# 从线性注意力到 Test-Time Training
> 本文基于 CVPR 2026 论文 [ViT$^3$: Unlocking Test-Time Training in Vision](https://arxiv.org/abs/2512.01643)。
在这篇文章中,我们将探讨注意力机制与序列建模之间的联系,以及这种联系如何引出一种名为**测试时训练**(TTT)的新范式。首先,让我们简要回顾标准的 softmax 注意力与线性注意力。
## Softmax 注意力
令 $Q, K \in \mathbb{R}^{N \times d_k}$ 分别为 query 矩阵和键矩阵,$V \in \mathbb{R}^{N \times d_v}$ 为值矩阵。标准的 scaled dot-product 注意力为
$$
O = \operatorname{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V,
$$
计算所有 query 与键两两之间的分数的复杂度为 $O(N^2 d_k)$,而对值进行加权累加的复杂度为 $O(N^2 d_v)$。由于通常 $d_k = d_v$,可将其直接写作 $O(N^2 d)$。由于此计算复杂度与 $N$ 呈平方关系,普通 softmax 注意力处理长上下文时效率低下。
## 线性注意力
*线性注意力*用可分解的核函数取代 softmax 相似度,并使用特征映射 $\phi: \mathbb{R}^{d_k} \to \mathbb{R}^{r}$ 将其逐行应用于 $Q$ 和 $K$,从而定义
$$
\kappa(q_i, k_j) = \phi(q_i)^T \phi(k_j), \quad \forall i,j.
$$
在一些变体中,$\kappa$ 用于近似 softmax 的指数核;在另一些变体中,它则是为提升效率而选择的其他核函数。
将其代入注意力公式可得:
$$
\begin{aligned}
o_i &= \frac{\sum_{j=1}^{N} \phi(q_i)^T \phi(k_j) v_j}{\sum_{j=1}^{N} \phi(q_i)^T \phi(k_j)}, \\
&= \frac{\phi(q_i)^T \left(\sum_{j=1}^{N} \phi(k_j) v_j^T\right)}{\phi(q_i)^T \left(\sum_{j=1}^{N} \phi(k_j)\right)}, \\
&= \frac{\phi(q_i)^T S}{\phi(q_i)^T z},
\end{aligned}
$$
其中
$$
S = \sum_{j=1}^{N} \phi(k_j) v_j^T, \qquad
z = \sum_{j=1}^{N} \phi(k_j).
$$
这里,$S$ 可看作所有键值对信息总和的摘要,而 $z$ 可看作大小归一化项。
其中,$S \in \mathbb{R}^{r \times d_v}$、$z \in \mathbb{R}^{r}$ 和 $o_i \in \mathbb{R}^{d_v}$。计算出 $S$ 和 $z$ 后,求一个输出 token $o_i$ 的成本为 $O(r d_v)$,因此计算全部输出 $O$ 的成本为 $O(N r d_v)$。在常见的 $r = d_v = d$ 情况下,这一复杂度变为 $O(Nd^2)$:相对于序列长度 $N$ 呈线性增长。
Linear Attention 出自论文 [*Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention*](https://arxiv.org/abs/2006.16236)。
## 因果线性注意力
在自回归生成中,只有序列的前缀是可见的,并且序列会随着时间不断增长。线性注意力可以以增量方式维护状态 $S$ 和 $z$:
$$
\begin{aligned}
S_t &= \sum_{j=1}^{t}\phi(k_j)v_j^T, \\
z_t &= \sum_{j=1}^{t}\phi(k_j).
\end{aligned}
$$
当 $r = d_v = d$ 时,为长度为 $t$ 的前缀预计算 $S$ 和 $z$ 的复杂度为 $O(t d^2)$。此后,每出现一个新 token,状态都会按如下方式更新:
$$
\begin{aligned}
S_{t+1} &= S_t + \phi(k_{t+1})v_{t+1}^T, \\
z_{t+1} &= z_t + \phi(k_{t+1}).
\end{aligned}
$$
每次更新的成本为 $O(d^2)$,因此处理长度为 $N$ 的序列,总体复杂度仍为 $O(Nd^2)$。
## 从另一个角度理解注意力
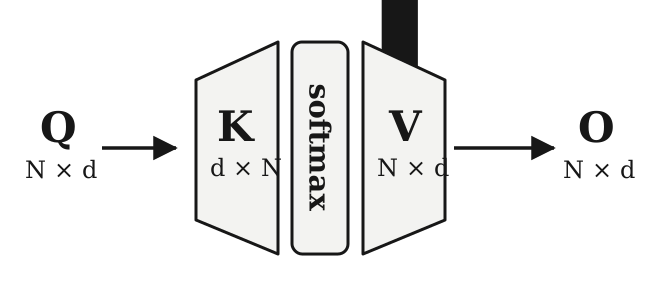
我们可以用下面的方式重新表述这两类注意力。当 $K$ 和 $V$ 固定时,softmax 注意力计算
$$
O = \sigma(QK^T)V,
$$
这里,可以将 $Q$ 看作线性层 $K^T$ 的输入,随后经过 softmax 激活,再通过一个不带激活函数的线性层 $V$。这相当于一个中间带有非线性函数的双层 MLP。
 对于线性注意力,我们可以考虑最简单的*未归一化*形式,并有意省略特征映射。根据结合律,有
$$
O = (QK^T)V = Q(K^TV).
$$
类似地,我们可以将 $Q$ 看作线性层 $K^T V$ 的输入(该层的权重可以预先计算)。这相当于一个单层 MLP。
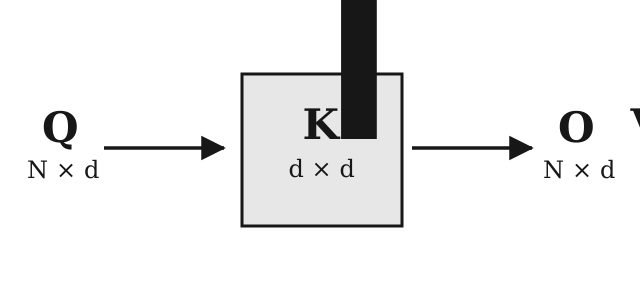 **这里的模式已经很清楚了:以 $K$ 和 $V$ 作为参数构建一个模型,再将该模型应用于 $Q$,得到输出。这是对注意力机制的一种重要重述。**
这里,中间的 MLP 可以被看作一个序列建模函数。这一视角下,Softmax 注意力与线性注意力的关键区别在于:softmax 注意力让每个 query 都能访问各个键和值,而线性注意力会先将它们压缩为固定大小的摘要。这种压缩使线性注意力更加高效,但也可能限制每个 query 可获得的信息。
于是,序列建模也可以被看作一个压缩问题:为已经观察到的序列构建紧凑表示,再利用这个表示预测未来的 token。其核心权衡在于这种表示的保真度,以及构建并计算它所需的成本。由此自然会产生一个问题:我们能否学习一种比人工设计的线性注意力表达能力更强,同时仍能保持线性成本的压缩函数?
一种可能的答案是使用**神经网络**。自监督学习可以将大型训练集编码进模型权重,同时捕捉数据中有用的结构与关系。这一思路引出了**测试时训练**(Test-Time Training, TTT)的概念。
这一想法最早在论文 [*Learning to (Learn at Test Time)*](https://arxiv.org/abs/2310.13807) 中提出,随后在 [*Learning to (Learn at Test Time): RNNs with Expressive Hidden States*](https://arxiv.org/abs/2407.04620) 中得到了进一步发展。
## Test-Time Training 范式
TTT 将键值对视为一个小型数据集,在推理时,一个*内部模型*对损失函数 $\mathcal{L}(\hat{V}, V)$ 进行优化,学习从 $K$ 到 $V$ 的映射,从而将当前序列压缩进模型参数。随后,$Q$ 作为输入传递给这个在推理时训练的模型,得到 $O$。由于这种优化发生在推理过程中,因此称为*测试时训练*。
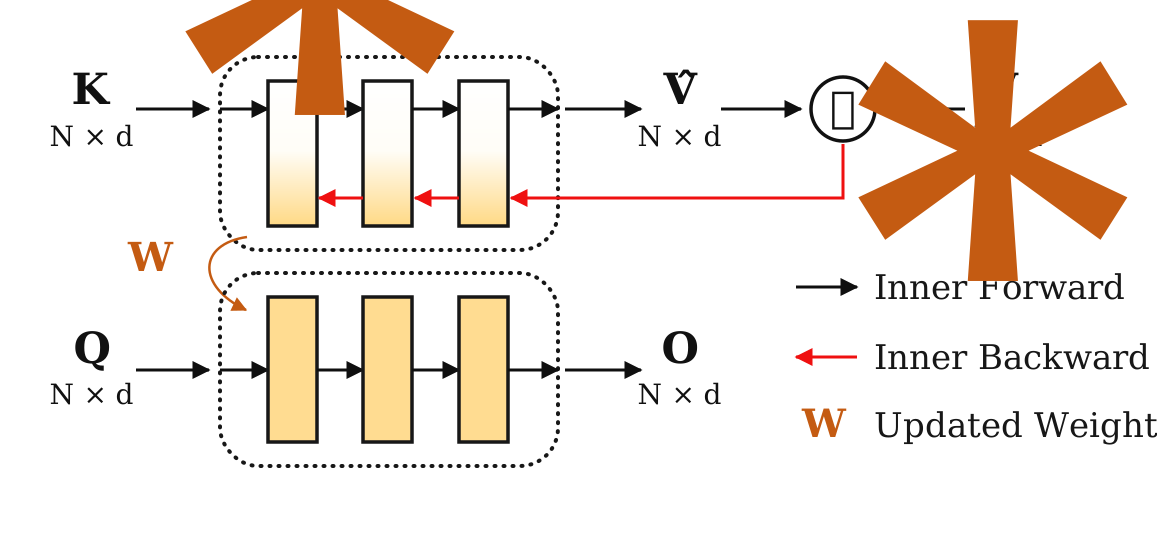 正式来讲,令 $f(\cdot; W)$ 表示临时参数为 $W$ 的内部模型。对完整序列进行的一次内部模型更新可以写为
$$
W' = W - \eta \nabla_W \sum_{i=1}^{N} \mathcal{L}\left(f(k_i; W), v_i\right),
\qquad
O = f(Q; W').
$$
这次更新旨在将当前序列压缩进 $W'$。在因果场景中,同样的思路会根据每个不断增长的前缀更新状态:
$$
W_t = W_{t-1} - \eta \nabla_W \mathcal{L}\left(f(k_t; W_{t-1}), v_t\right),
\qquad
o_t = f(q_t; W_t).
$$
### 外循环
在常规训练阶段,*外循环*负责优化任务损失;但为了实现这一目标,它也必须对内循环进行"优化"。外循环会学习生成 $Q$、$K$ 和 $V$ 的投影,有时还会一并学习内部模型的初始化参数 $W_0$——这些因素都会影响内循环的优化过程。
部署时,外循环参数会被冻结,而内部模型则会在测试时针对每条新序列进行适应(训练)。因此,外循环在某种意义上讲是一个元学习目标:它学习一组能让内循环适应过程更加有效的参数。
原则上,内部模型可以采用任意可微的神经网络架构,由此形成了广阔的设计空间。论文 [ViT$^3$: Unlocking Test-Time Training in Vision](https://arxiv.org/abs/2512.01643) 对视觉领域中的这一设计空间进行了研究。
### 实际局限
TTT 避免了显式构造全部 $N^2$ 个 query 与键之间的交互矩阵,但相对于 $N$ 呈线性增长并不意味着没有成本。一个线性内部模型通常需 $O(Nd^2)$ 的计算量;但由于它需要在运行时进行在线训练,还必须执行反向传播,这大大增加了计算量,并对内存吞吐造成压力。因此,内部模型必须足够小,才具备实用性;同时,外循环也必须学到良好的初始化参数,使内部模型只需少量梯度更新就能有效工作。